LingX-TTS发布:让 Voice Design 从"描述声音"走向"设计表达"
让模型不仅知道“谁在说”,还知道“应该怎么说”。
Introduction:从“描述声音”走向“设计表达”
今天,我们发布了 LingX-TTS,一款面向声音设计(Voice Design)的高表现力语音生成模型。该模型的核心目标是在保证指令遵循能力的基础上,生成在特定场景下具有高表现力的音频,以提高模型在不同真实场景中的可用性。
为了生成符合人类偏好的高表现力音频,我们强调模型基于特定场景生成音频的自然度和表现张力。对于表现力,LingX-TTS 还针对性地强化了模型的副语言生成表现能力。最终,在保证自然流畅的前提下,我们的 LingX-TTS 已经能够表现出符合场景上下文的强大表现力,尤其是还能够在讲话过程中添加丰富生动的副语言信息。
先听两个例子
下面两个例子展示了 LingX-TTS 在不同场景与表达要求下的声音设计效果。更多效果可以前往 LingX Playground 体验。
Instruction Following:把自然语言指令稳定变成可听特征
除了生成高表现力的音频,我们首先希望模型的表现能很好地符合用户的要求和预期。指令遵循能力作为声音设计的基础能力,要求模型生成一个符合指令要求的声音。我们希望 LingX-TTS 不仅仅是能够理解和遵循几个孤立的形容词,而是同时能够将其形成一整套相互关联的表达方式。因此,LingX-TTS 面向不同粒度和不同形式的声音设计指令进行了训练,基于特定指令的音频生成变成可以描述、可以控制、可以复现的产品能力。
示例
中国女性儿童故事讲述者,声音温暖明亮、声情并茂,语速不要太快,讲述感。中文旁白自然有画面感,进入小熊对白时稍微更加天真、好奇,但不要刻意改变音色。英文对白自然融入故事,不要突然变成英语教材朗读。看到雪时有真实的惊喜感,结尾带轻微笑意。中英文切换保持情绪连续。
小熊一觉醒来,发现窗外变得白茫茫的。它赶紧跑到窗边,睁大了眼睛:“Wow! What happened outside?” 熊妈妈笑着告诉它,这是今年冬天的第一场雪。小熊立刻跑到门口,伸出小爪子接住一片雪花。“It’s so cold!” 它开心地笑了起来,“Can I go outside and play?”
InstructTTSEval
指令遵循是 TTS 模型的基础能力之一,我们基于 InstructTTSEval 基准[7]对其进行评估。InstructTTSEval 是一套面向 TTS 模型的综合性评测基准,专门被设计用来测试 TTS 语言设计模型按照特定指令生成语音的基础能力。 它采用分层评测框架,设置 3 个难度逐级递增的任务,同时检验模型底层声学控制能力和高层风格泛化能力:
声学参数指定任务(APS)测试模型对底层声学属性的精细控制,例如音调、语速、音量、音色等参数的指令跟随效果。
描述性风格指令任务(DSD)检验模型理解并执行高阶风格描述的能力,比如 “温柔的朗读”“沉稳正式的旁白” 这类自然语言风格要求。
角色扮演任务(RP)评估模型根据角色、场景描述,理解上下文并自适应切换语音风格的能力。
我们基于此 Benchmark 对多个模型的指令遵循能力进行了评估,其在中英文上的平均表现如下图所示:
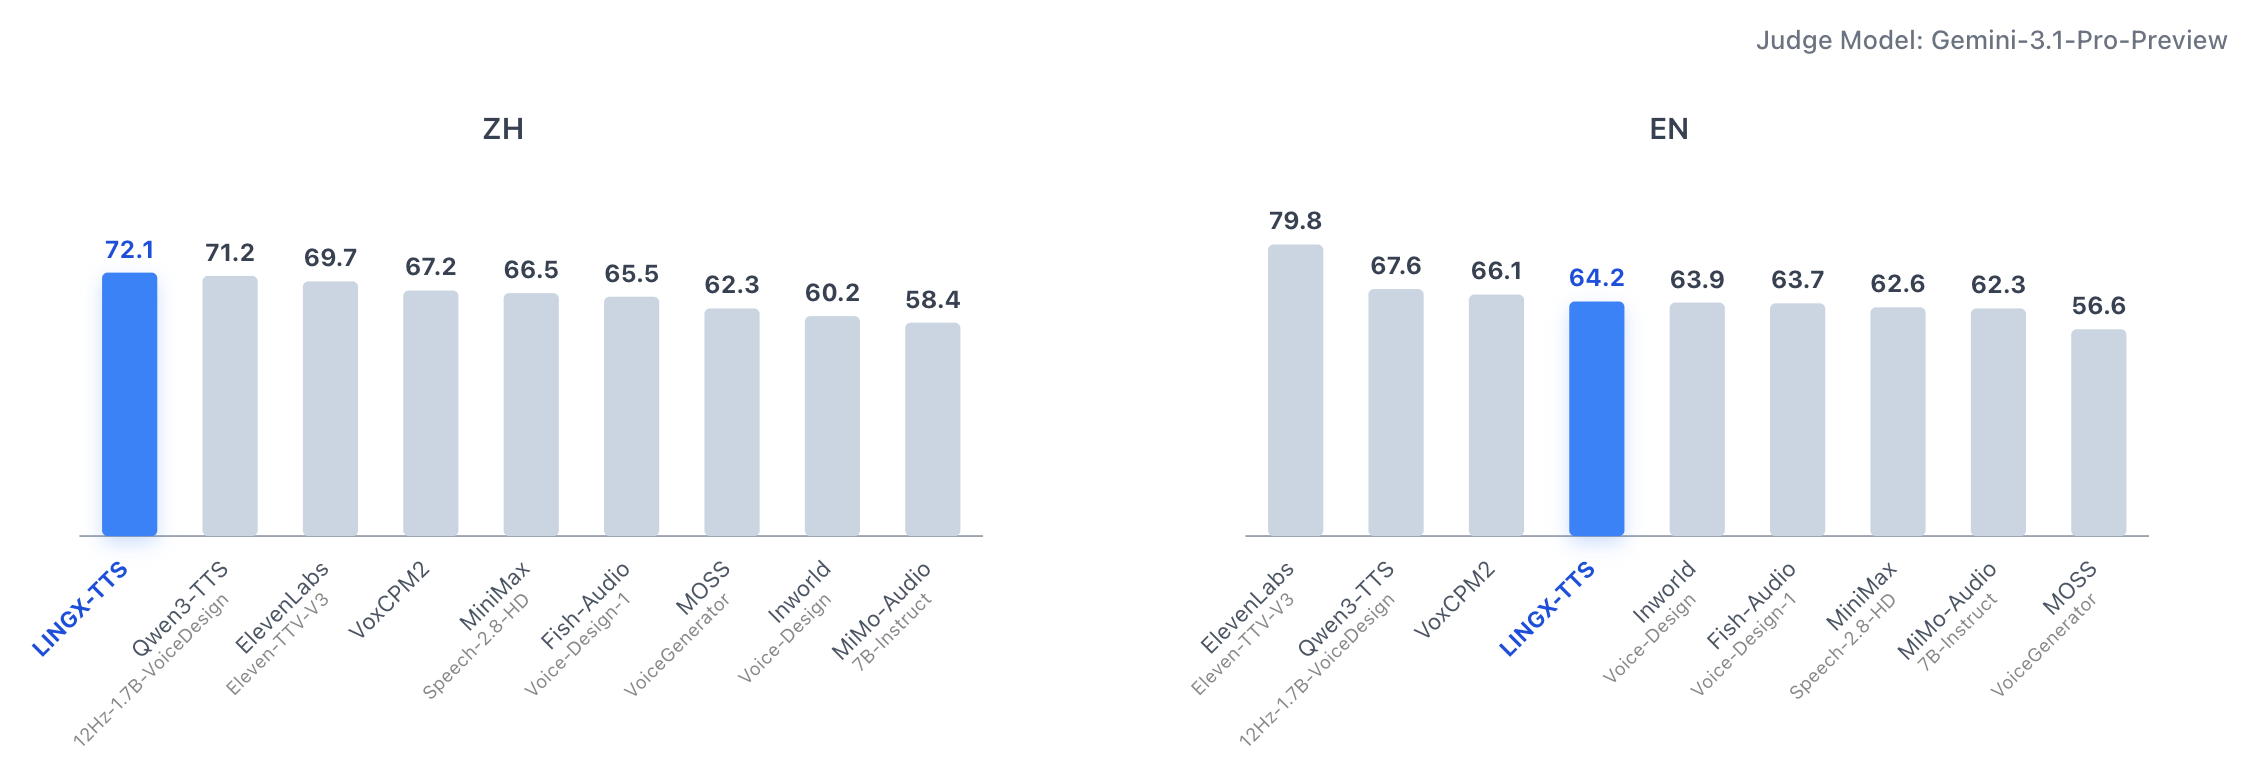
结果显示,LingX-TTS 在中文的指令遵循上取得了 72.1 分,显著领先同类模型;同时我们在英文上取得了 64.2 分,也表现出优秀的指令遵循能力。同时,LingX-TTS 在各项子任务上表现出的指令遵循能力也均位于第一梯队。强大的指令遵循能力使得 LingX-TTS 能够有效地按照用户的意愿和指令生成符合预期的高表现力音频。
Expressiveness:场景化的高表现力
人类说话时,很少会先把表达拆解成:
emotion = happy
pitch = high
speed = fast
真实而高表现力的表达通常来自整个场景。优秀的 TTS 不应该只是基于几个离散的属性进行机械地复现和表达,它需要理解:
此时此刻此景,这句话应该怎样被说出来。
当用户去描述一段声音时,他真正想要的往往并不是某个固定的音高或语速,而是这个音频真的像那个角色在那个场景下说出来的。因此,在 LingX-TTS 中,情绪、韵律、强度、重音和节奏等元素不再是彼此独立的控制旋钮,而是共同构成一次完整的声学表达。
示例
女性,青年,音色清亮自然,带有日常生活的鲜活感,使用中文,场景为“朋友闲聊/分享尴尬偶遇”。带着偶遇奇事的兴奋与回想时的窘迫,讲述前段时语速轻快、语气上扬,透着夸张的不可思议;说到“脑子一懵”处短暂停顿,语气骤降,声音微缩;吐出“挺好吃的”时音量极轻、带着干涩的气音;结尾余惊未消,语调拖长发虚,透出强烈的社死尴尬。
哎我跟你说,今天早上那事儿真是绝了。我本来都迟到了,结果电梯到一层的时候,居然碰到我们老板。你猜怎么着?他居然主动跟我打了招呼,还问我昨天方案写得咋样。我当时脑子一懵,差点说 "挺好吃的"。真的,尬死我了。
ExpressTTS-Bench
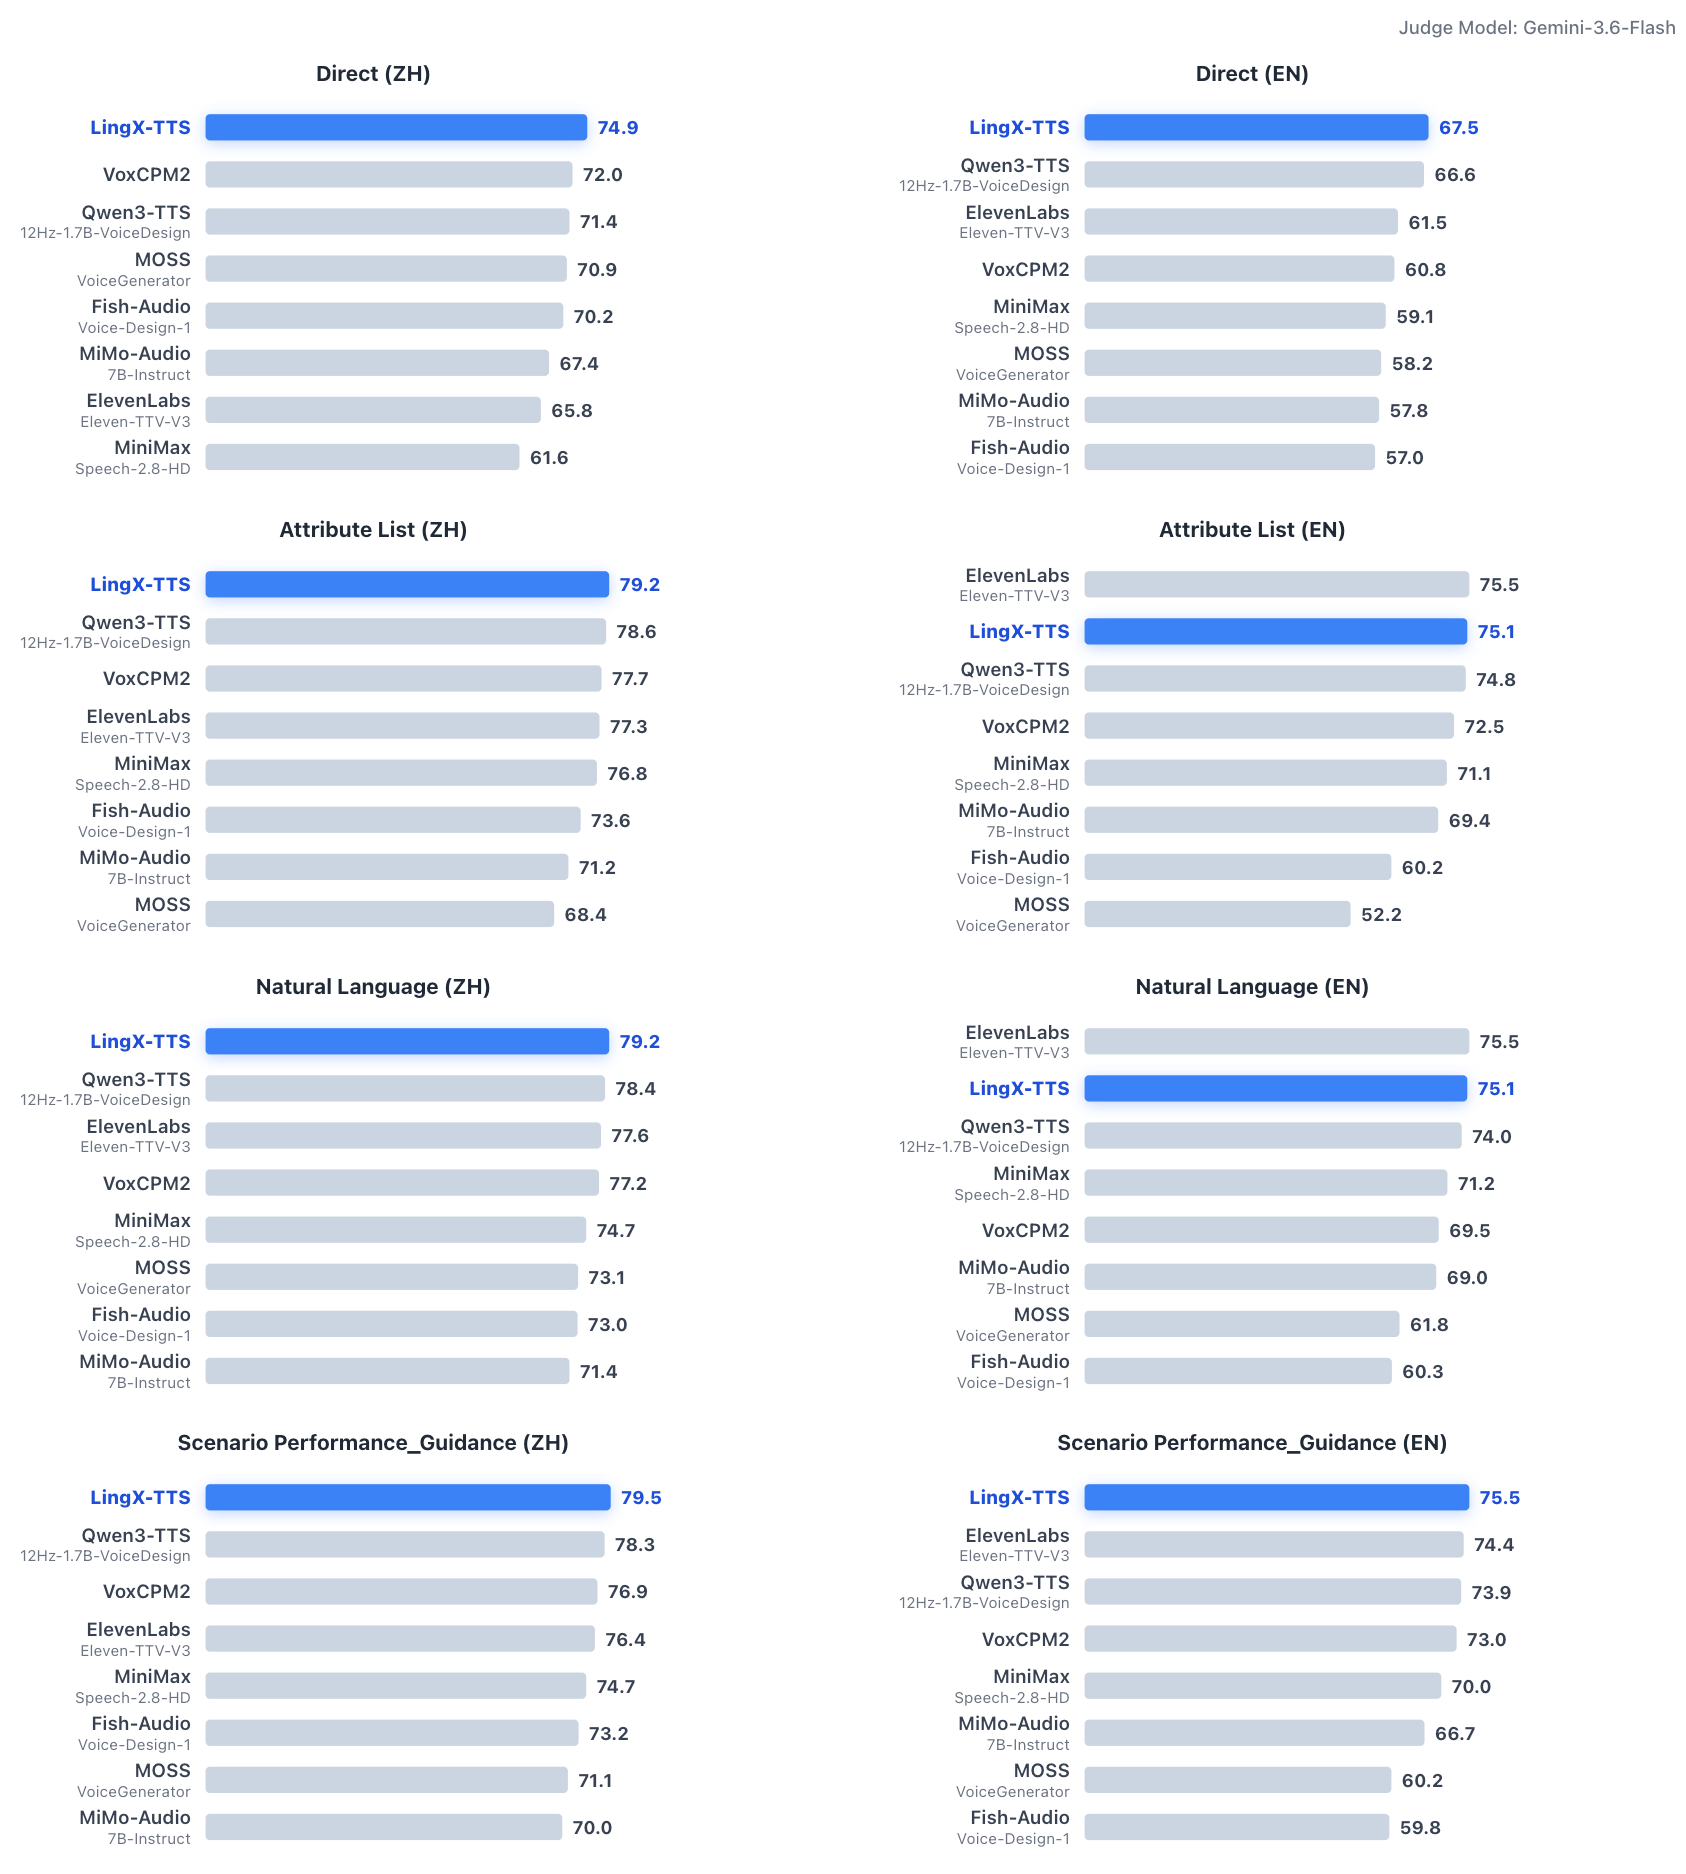
在这一过程中,我们发现当前针对 TTS 模型的表现力缺乏系统而有效的评价基准。一段语音完全可能非常自然、非常清晰,却无法达到用户期望的角色、情绪或者场景的要求。因此,伴随 LingX-TTS,我们还全面探索了 TTS 模型的表现力评估,并设计了一个全新的基于场景的音频表现力评测 Benchmark——ExpressTTS-Bench。相较于直接用一个总分概括表现力,ExpressTTS-Bench 将 TTS 的表现力从情感、韵律和副语言几个方面进行分析,并进一步将其拆解为九个不同的子维度进行系统评估。同时,我们还使用不同形式的提示方式考察模型,包括空指令(Direct)、属性列表(Attribute List)、自然语言指令(Natural Language)以及场景化表演指导(Scenario Performance Guidance),以全面评估模型在不同提示风格下的泛化性。我们的评测基准经过检验与人类评估之间也表现出良好的一致性。这一 Benchmark 在我们即将发布的文章中会进行进一步的全面介绍,并开源相关代码和数据。
示例
林检察官,你们的正义是同一杆秤吗?穷人越线叫犯罪,权贵越线叫个案;我游走边缘,你们就连夜修规则,自己人踩线,你们就坐下来谈苦衷。这样一杆两头换砣的秤,值得你守到深夜吗?
(None)
请按照以下设定生成目标文本对应的音频:
表达模式:角色化表达
······
情感:由平静铺陈层层递进,到居高临下的讥诮反问
音质:低沉醇厚,胸腔共鸣饱满,尾音带一丝轻哂的沙哑
······
请以角色化表达演绎一段反派与反英雄对正义信念的挑衅解构。具体情境是角色在深夜讯问室中被对方以正义之名质问时,决定揭露规则背后的双重标准并动摇其信念根基。声音为中年男性嗓音,低沉醇厚,······
角色画像:一位身处深夜讯问室的中年男性。他拥有低沉醇厚的嗓音,共鸣集中在胸腔,吐字缓慢而清晰,整体气质冷静克制,带着居高临下的从容。
具体情境:在深夜的讯问室里,面对对方以正义之名的质问,他决定用冷静而锋利的言辞,层层剥开规则背后的双重标准,以此挑衅并动摇对方坚守的正义信念。
场景化表演指导:这是一场智力与信念上的居高临下解构。声音要像在暗处好整以暇地拨弄猎物,展现出绝对的掌控力。开篇以平静的铺陈引入,音量低缓克制,······
结果显示,LingX-TTS 在多项指标上都达到了 SOTA 的性能,表明其在各种不同的任务类型上都可以表现出强大的表现力。具体来说:
在四种提示形式下,LingX-TTS 均表现出较强的综合表现力和稳定性。在中文评测中,LingX-TTS 在属性列表、属性列表、自然语言指令和场景化表演指导任务下的综合均分在四种设置下均位列第一。英文评测中除属性列表和自然语言指令设置下略低于 ElevenLabs 外,LingX-TTS 在空指令和场景化表演指导设置下均取得最高分。
Paralanguage:有些表达,本来就不在文字里
除了讲话文本外,人类交流中的大量信息并不来自词语本身。笑、叹息、哭泣、呼吸、咳嗽、喷嚏等等非词汇性发声,通常统称为副语言(Paralanguage)。在真实交流中,它们承担着重要的信息。按照指令要求或自发地添加合适且富有表现力的副语言信息,对于实现具有高表现力的音频生成至关重要。在 LingX-TTS 中,针对高表现力的音频生成,我们尤其强化了副语言的表现。对于 LingX-TTS 而言,这些声音不再只是偶然生成出来的“彩蛋”,而能够成为 Voice Design 的一部分。
示例
男性,中年,音色温润且带有轻微的颗粒感,共鸣集中在胸腔,整体气质亲和、自然、稳重,使用中文,场景为“乏味无聊 / 等待进度条与系统更新”。从乏味无聊到困倦懈怠,表达中自然带有哈欠,气流长长呼出并伴随低频声带震颤;哈欠结束后的短暂话语略显含混,随后恢复正常,但整体仍慵懒散漫,带着漫长等待中的困意。具有富有表现力的戏剧化语气,适合语音合成。
这都等半天了,怎么才百分之十五……早知道这么慢,我就不在这儿耗着了。困死了,算了,再等五分钟,不行我真睡了。
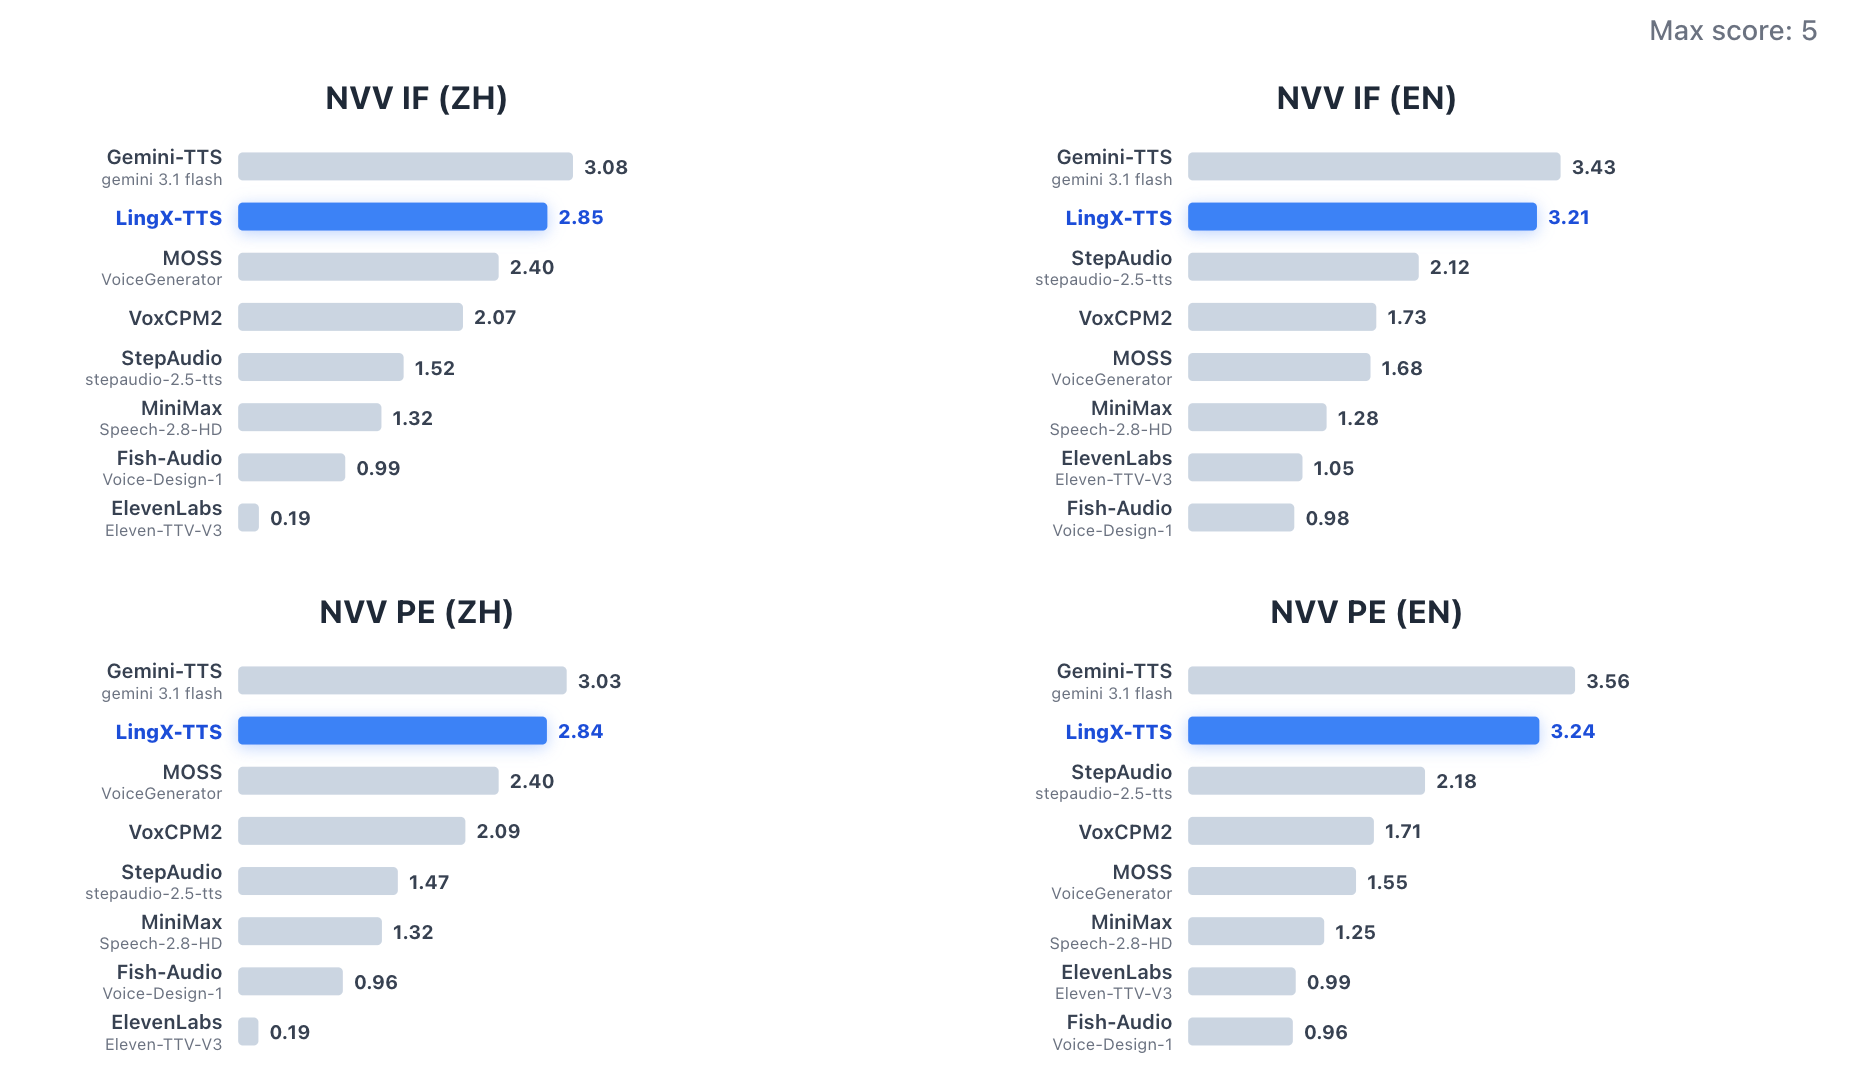
在 LingX-TTS 中,我们既要求模型能够生成指令中对应的正确副语言信息,同时也要求生成的副语言信息能够产生合理的表达效果。在专门用于评测 TTS 模型副语言生成的评价基准 NVV-SuperBench[13]上,LingX-TTS 显著领先同类模型,显示出强大的副语言生成表现能力。
NVV-SuperBench
在实验设计上,我们沿用 NVV-SuperBench 基准的评测维度与任务设定。但为了进一步提高评测过程中副语言识别和位置对齐时的稳定性,我们进一步调整评测方案,采用匿名人工盲评:所有音频样本剥离模型信息,5 位专家标注员在不知道样本归属的前提下独立评分。NVV PE (Nonverbal vocalizations Perceptual Effect)主要评价副语言本身的自然度、表现力,以及它是否增强了整体表达;NVV IF (Nonverbal vocalizations Instruction Following)判断音频是否按照 prompt 中的副语言要求生成,包括类型、表达方式和要求的位置,满分均为5分。在这套更稳健的人工评测下,我们的模型在各个评测子集上均仅次于 Gemini-TTS,大幅领先其余模型。
从场景化数据合成到强化学习:真正教会模型“怎么说”
高质量的场景化高表现力数据
大规模语音数据通常能够很好地覆盖语言内容、说话人和基础音色,但真正强烈、细腻且具有明确场景动机的表达。在自然数据中往往既稀缺又高度不均衡。更重要的是,高表现力并不是一个可以独立于场景存在的标签。因此,我们没有把高表现力数据构造简单理解成“增加更多情绪语音”,而是把它看作一个场景化表达空间的系统构造问题。
高表现力语音本身具有非常强的场景依赖性和长尾性。同一种情绪,在不同角色、关系、语境和交互意图下,最终呈现出的声音可能完全不同。一个人在“愤怒地争吵”和“压抑着愤怒进行质问”时,都可以被描述为“愤怒”的情绪,但二者在音高变化、语速、强度、停顿、重音乃至呼吸方式上都会产生显著差异。因此,我们精心制作了大量私有的多样化、场景化的高表现力语音训练样本数据。我们不仅仅是单纯扩大样本数量,也希望能够让不同能力以足够丰富的组合形式共同出现。我们还为模型的迭代训练构造了全自动、可扩展的数据合成 pipeline,实现了对于场景、身份、情感等等复杂元素的组合式覆盖,并特别强调基于情景上下文的情感、韵律、副语言的高表现力。
全流程训练范式
在训练上,我们采用了一套贯穿 Pretraining → Supervised Fine-Tuning → Reinforcement Learning 的完整训练范式。
Pre-training:建立广泛而稳定的语音生成能力
在预训练阶段,我们首先让模型从大规模、多样化的语音数据中建立对文本与语音之间关系的基础理解。 这一阶段的重点并不是要求模型立即完成复杂的 Voice Design 指令,而是形成稳定的语音生成基础,包括文本内容、发音、韵律、说话人特征以及丰富声音模式之间的建模能力。 对我们而言,这一步决定了模型能够覆盖多大的声音空间,也为后续学习更细粒度、更复杂的表达控制提供了基础。
SFT:建立自然语言与声音表现之间的显式对齐
在 SFT 阶段,我们的训练数据包含多样的声音描述形式,让模型学会如何把自然语言要求映射为具体、可感知的声音特征。训练数据中的声音描述不仅覆盖音色、音高、语速等相对明确的属性,也包含角色、情绪、场景以及多个约束同时出现的复杂描述。尤其重要的是,我们加入了大量场景化高表现力数据。它们并不只是告诉模型“这是一段悲伤的声音”或“这是一段激动的声音”,而是尽可能提供更加完整的表达语境。 我们进行 SFT 的目标,就是让原本隐含在人类声音中的情景化表达差异,逐渐成为人类可以通过自然语言调用的模型能力。
RL:不仅生成正确的语音,也优化更合适的表达
我们也观察到,单纯依赖监督学习仍然存在明显局限。 对于同一个声音设计指令,往往存在大量基本符合要求的生成结果。它们在字词内容上都可能正确,甚至整体听起来都很自然,但在表现力、指令匹配程度和内容准确性之间仍然存在显著差异。因此,在 SFT 之后,我们进一步引入了基于 GRPO(Group Relative Policy Optimization)[12] 的强化学习阶段,让模型能够在多个候选生成之间学习更加细粒度的质量偏好。 我们没有使用单一指标进行优化,而是从四个彼此互补的方向构建奖励信号:
内容准确性(Content Accuracy):使用 WER 评价语音内容是否准确,避免模型为了追求更夸张的表现力而牺牲可懂度和文本忠实度;
音频质量(Audio Quality):使用 DNSMOS[10] 评价生成语音的整体音质,约束模型避免在强化表现力的过程中引入明显的噪声、失真或其他感知质量退化;
指令遵循(Instruction Following):使用 InstructTTSEval[7] 的评估方法构建指令遵循评价,用于衡量最终生成的声音是否真正落实了用户在自然语言中提出的要求,并提供奖励信号;
表现力(Expressiveness):基于 AudioBox-Aesthetics[11] 构建表现力相关的评价信号,鼓励模型生成更高表现力的结果。
通过多目标强化学习优化,LingX-TTS 在内容准确性、音频质量、指令遵循与表现力等多个目标之间取得了更优的整体平衡。
来自 LingX-TTS 的更多生成示例
致谢
感谢清华大学计算机系 CoAI 课题组对本项目的支持,感谢 Zhipu AI GLM-TTS 团队在早期对本项目的支持与贡献。
References
[1] Hangrui Hu, Xinfa Zhu, Ting He, Dake Guo, Bin Zhang, Xiong Wang, Zhifang Guo, Ziyue Jiang, Hongkun Hao, Zishan Guo, et al. Qwen3-tts technical report. arXiv preprint arXiv:2601.15621, 2026.
[2] Yitian Gong, Botian Jiang, Yiwei Zhao, Yucheng Yuan, Kuangwei Chen, Yaozhou Jiang, Cheng Chang, Dong Hong, Mingshu Chen, Ruixiao Li, et al. Moss-tts technical report. arXiv preprintarXiv:2603.18090, 2026.
[3] Jin Xu, Zhifang Guo, Hangrui Hu, Yunfei Chu, Xiong Wang, Jinzheng He, Yuxuan Wang, Xian Shi,Ting He, Xinfa Zhu, et al. Qwen3-omni technical report. arXiv preprint arXiv:2509.17765, 2025.
[4] Bowen Zhang, Congchao Guo, Geng Yang, Hang Yu, Haozhe Zhang, Heidi Lei, Jialong Mai, JunjieYan, Kaiyue Yang, Mingqi Yang, et al. Minimax-speech: Intrinsic zero-shot text-to-speech with a learnable speaker encoder. arXiv preprint arXiv:2505.07916, 2025a.
[5] Dong Zhang, Gang Wang, Jinlong Xue, Kai Fang, Liang Zhao, Rui Ma, Shuhuai Ren, Shuo Liu, Tao Guo, Weiji Zhuang, et al. Mimo-audio: Audio language models are few-shot learners. arXiv preprint arXiv:2512.23808, 2025b.
[6] Yixuan Zhou, Guoyang Zeng, Xin Liu, Xiang Li, Renjie Yu, Jiancheng Gui, Jiaheng Wu, Ziyang Wang, Xudong Shen, Runchuan Ye, et al. Voxcpm2 technical report. arXiv preprintarXiv:2606.06928, 2026.
[7] Kexin Huang, Qian Tu, Liwei Fan, Chenchen Yang, Dong Zhang, Shimin Li, Zhaoye Fei, QinyuanCheng, and Xipeng Qiu. Instructttseval: Benchmarking complex natural-language instruction following in text-to-speech systems. arXiv preprint arXiv:2506.16381, 2025.
[8] Elevenlabs. https://elevenlabs.io/voice-design
[9] Fish Audio. https://docs.fish.audio/features/voice-design
[10] Chandan KA Reddy, Vishak Gopal, and Ross Cutler. Dnsmos: A non intrusive perceptual objectivespeech quality metric to evaluate noise suppressors. In ICASSP 2021-2021 IEEE InternationalConference on Acoustics, Speech and Signal Processing (ICASSP), pp. 6493–6497. IEEE, 2021.
[11] Andros Tjandra, Yi-Chiao Wu, Baishan Guo, John Hoffman, Brian Ellis, Apoorv Vyas, Bowen Shi, Sanyuan Chen, Matt Le, Nick Zacharov, et al. Meta audiobox aesthetics: Unified automatic quality assessment for speech, music, and sound. arXiv preprint arXiv:2502.05139, 2025.
[12] Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu, Junxiao Song, Xiao Bi, Haowei Zhang, Mingchuan Zhang, YK Li, Yang Wu, et al. Deepseekmath: Pushing the limits of mathematical reasoning in open language models. arXiv preprint arXiv:2402.03300, 2024.
[13] Liumeng Xue, Weizhen Bian, Jiahao Pan, Wenxuan Wu, Yilin Ren, Boyi Kang, Jingbin Hu, Ziyang Ma, Shuai Wang, Xinyuan Qian, et al. Nvv-superbench: Beyond words, beyond quality-benchmarking nonverbal vocalizations in speech generation. arXiv preprint arXiv:2604.16211,2026.
[14] Gheorghe Comanici, Eric Bieber, Mike Schaekermann, Ice Pasupat, Noveen Sachdeva, Inderjit Dhillon, Marcel Blistein, Ori Ram, Dan Zhang, Evan Rosen, et al. Gemini 2.5: Pushing thefrontier with advanced reasoning, multimodality, long context, and next generation agentic capabilities. arXiv preprint arXiv:2507.06261, 2025.
[15] Aaron Hurst, Adam Lerer, Adam P Goucher, Adam Perelman, Aditya Ramesh, Aidan Clark, AJ Os-trow, Akila Welihinda, Alan Hayes, Alec Radford, et al. Gpt-4o system card. arXiv preprintarXiv:2410.21276, 2024.